Hiciste una página nueva para tu mejor servicio. Se ve muy bien. Un mes después no aparece por ningún lado en Google. Casi siempre la razón es sencilla: el rastreador de Google nunca la encontró, o la encontró y no entendió de qué trataba.
¿Qué es un rastreador web?
Un rastreador web (también llamado bot, araña o “crawler”) es un programa que visita páginas web, las lee y sigue sus enlaces para encontrar más páginas. El de Google se llama Googlebot. Bing, ChatGPT y las herramientas de SEO tienen el suyo.
Para un dueño de negocio, el rastreador importa por una razón: Google no puede mostrar una página que no ha encontrado y leído. Rastrear es el primero de los tres pasos de cómo funciona la Búsqueda de Google: rastrear, indexar y mostrar.
Cómo encuentra Google tus páginas
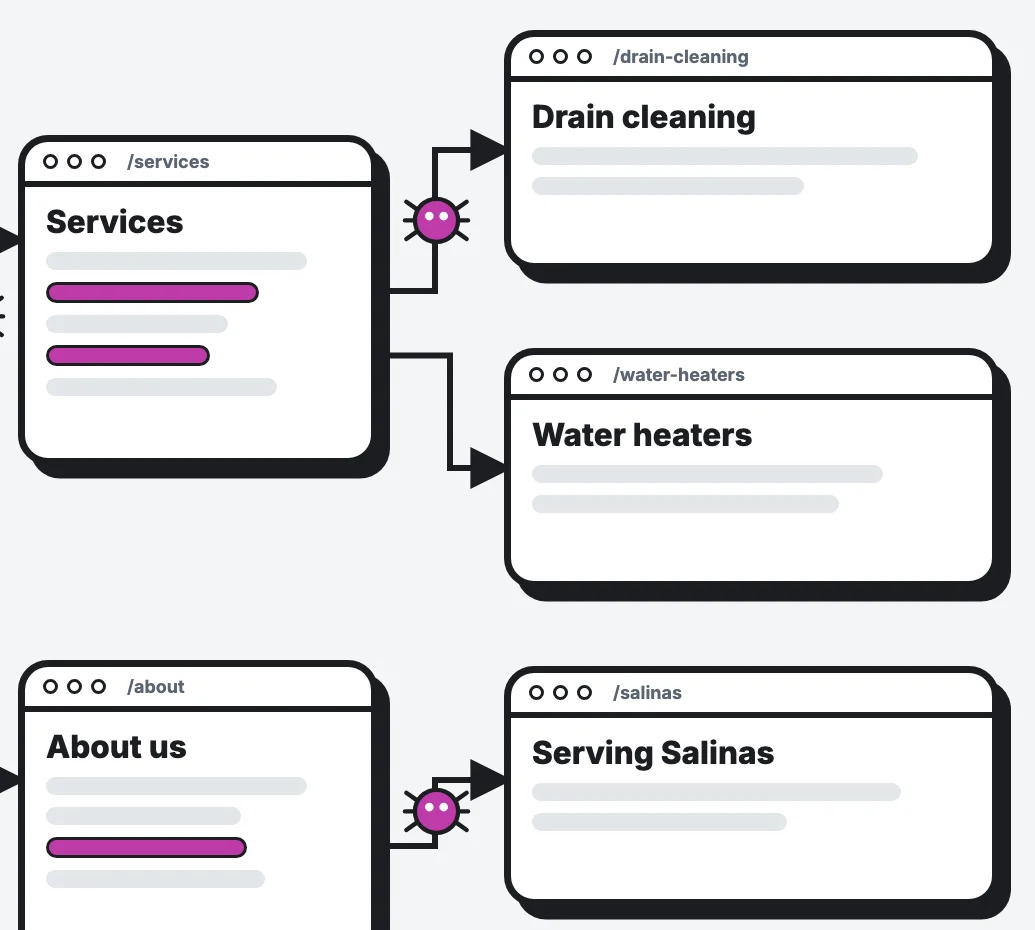
La guía de Google menciona tres formas en que conoce una página: ya la conoce, encuentra un enlace hacia ella desde una página que conoce, o tú la incluyes en un sitemap. Los enlaces hacen casi todo el trabajo. Google dice que la gran mayoría de las páginas nuevas que encuentra cada día las encuentra por enlaces.
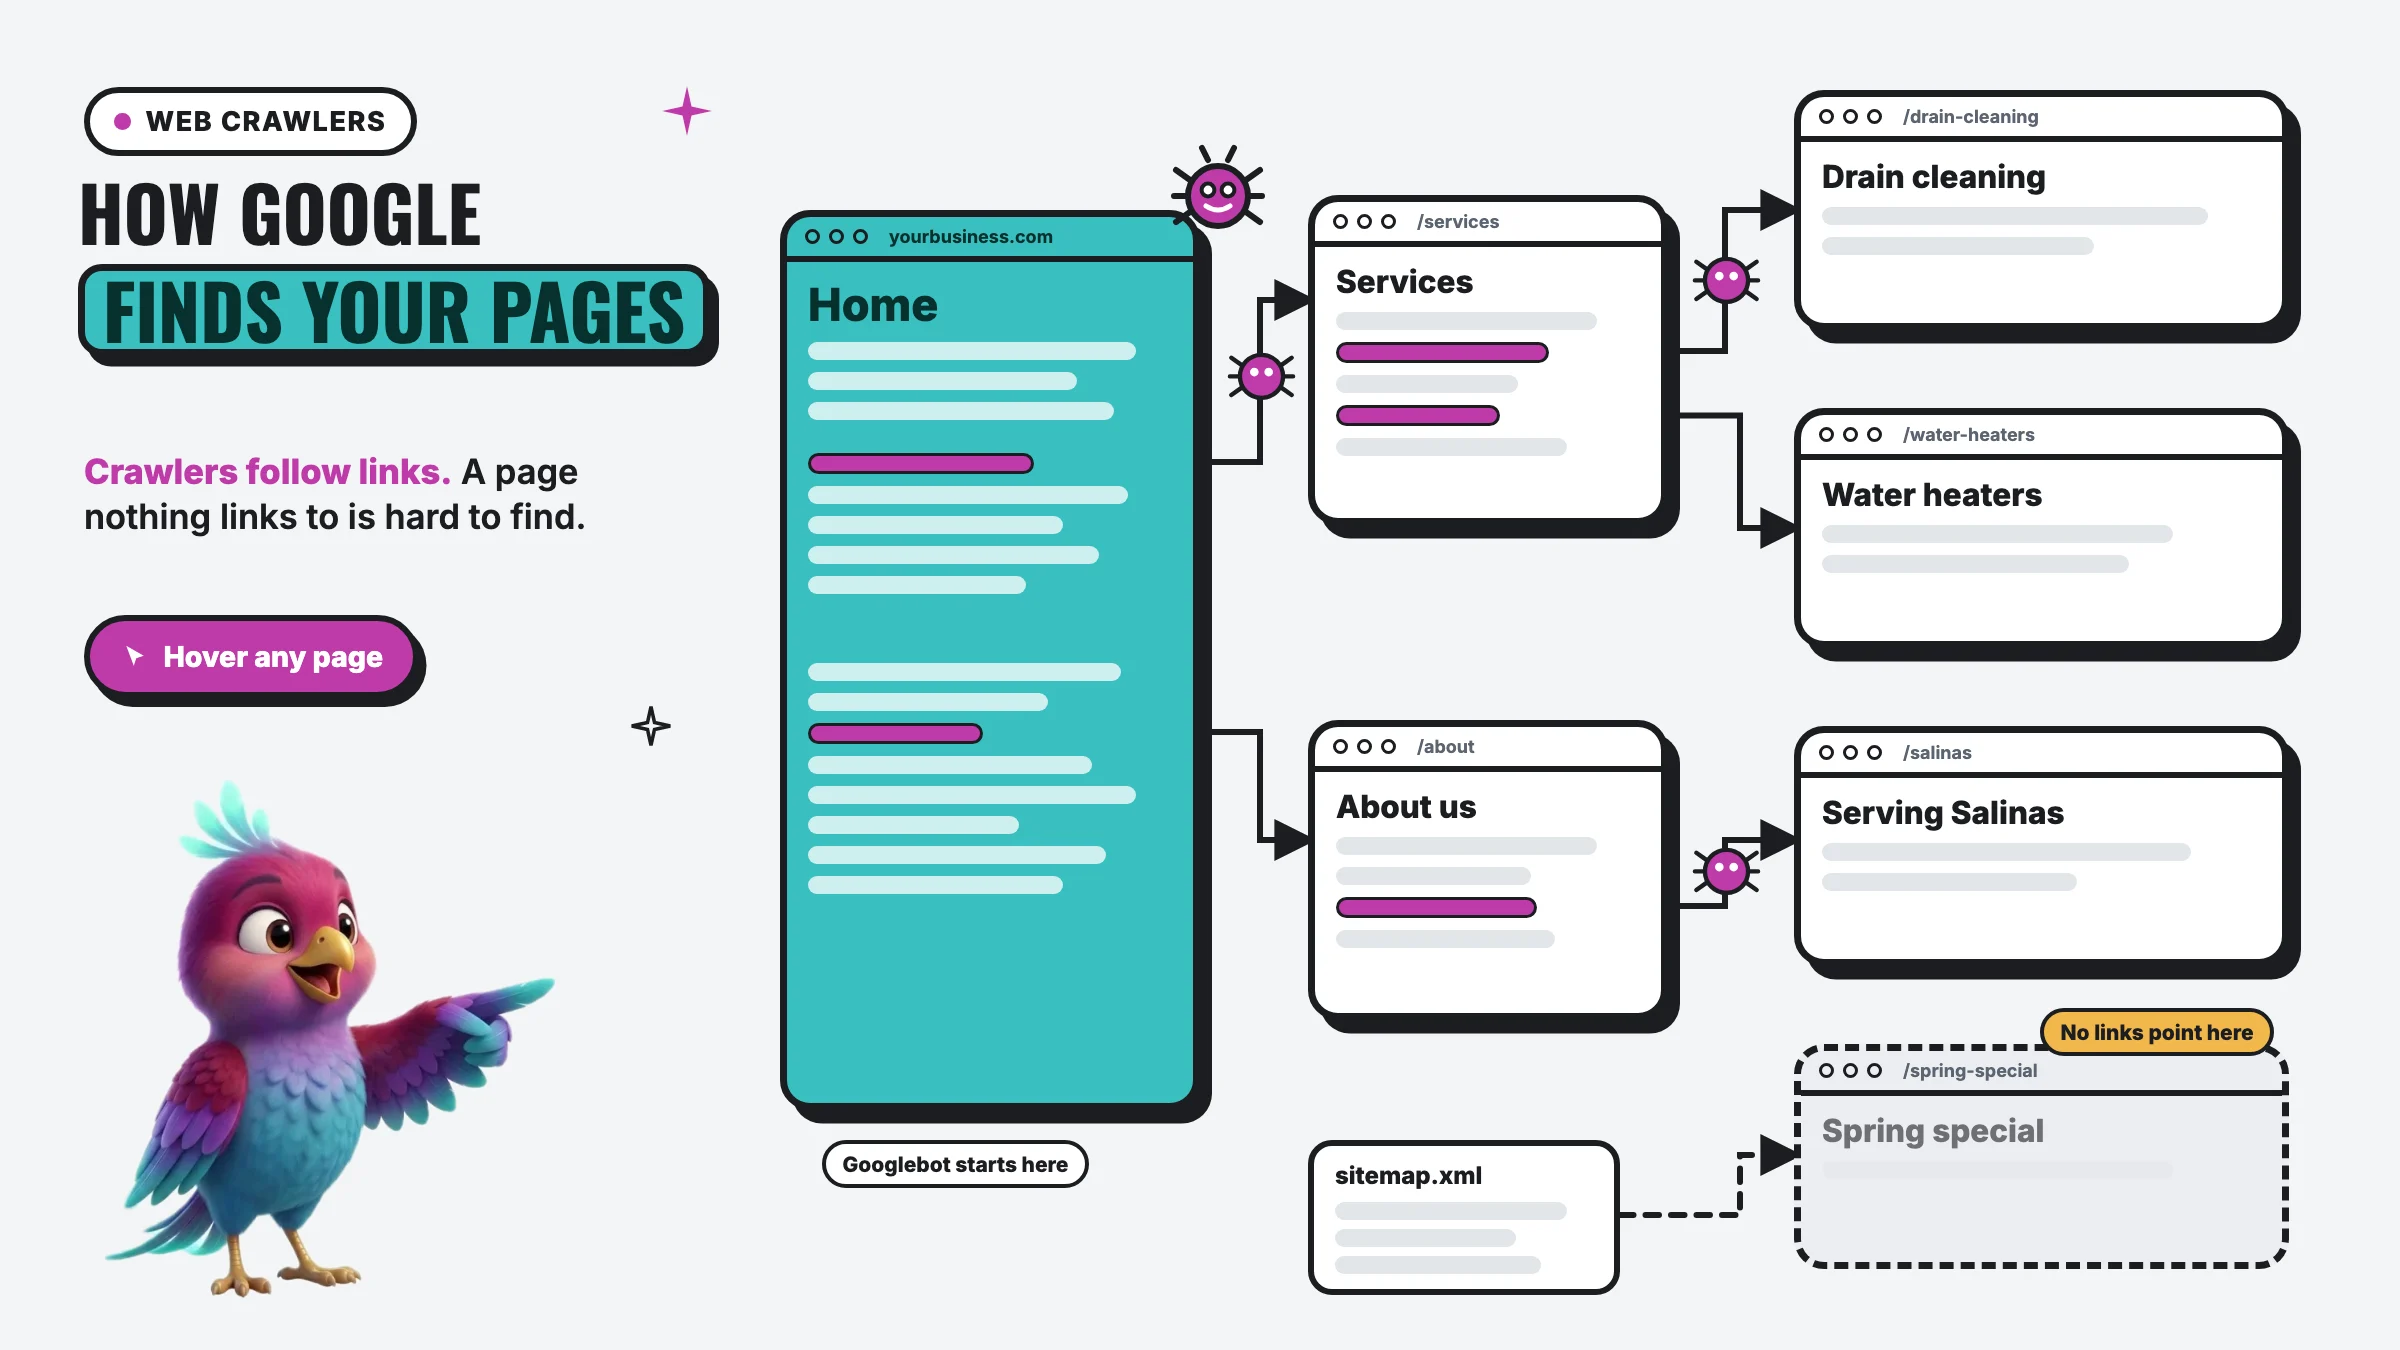
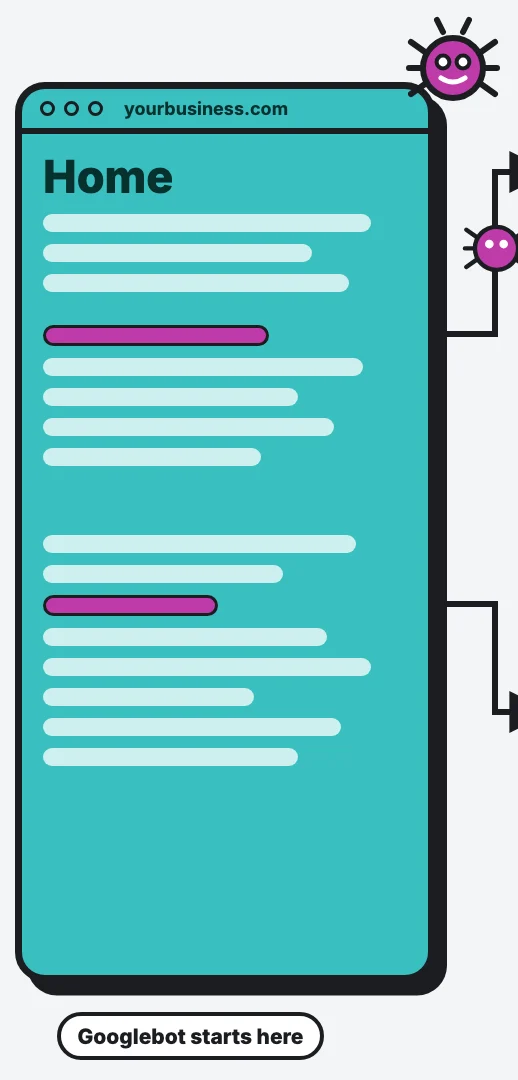
Eso es lo que muestra el gráfico de arriba. Googlebot empieza en tu página de inicio, sigue el enlace a Services y luego los enlaces de Services a cada página de servicio. Cada enlace es una puerta.
Así que tu menú y los enlaces dentro de tus páginas no son solo para tus visitantes. Son el mapa que usa el rastreador.
Páginas huérfanas: la página a la que nadie enlaza
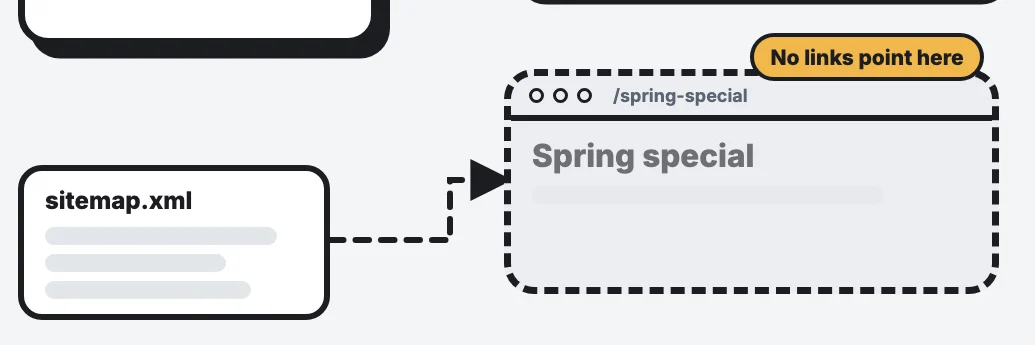
Fíjate en la página punteada del gráfico. Nada enlaza a ella. En SEO se le llama página huérfana, y pasa más seguido de lo que crees. Las de siempre:
- Una página de promoción o de temporada hecha para una campaña y nunca agregada al menú.
- Una página para anuncios hecha solo para anuncios de Google o Facebook.
- Una página de zona de servicio para una ciudad nueva que solo menciona el sitemap.
- Una página vieja que perdió sus enlaces en un rediseño.
Google es claro con la solución: cada página que te importa debe tener un enlace desde al menos otra página de tu sitio. Enlázala desde tu menú, tu página de servicios, un servicio relacionado o el pie de página.
Un detalle más: por lo general Google solo puede seguir un enlace si es un enlace <a> real con dirección (un href). Botones que solo funcionan con un script, o menús que cargan de una forma que Google no lee, pueden dejar páginas aisladas aunque a ti te parezcan enlazadas.
El sitemap ayuda, pero es un respaldo
Un sitemap es un archivo (casi siempre en /sitemap.xml) con la lista de tus páginas para los buscadores. La mayoría de las plataformas lo hacen por ti. Vale la pena tenerlo y enviarlo en Search Console y en Bing Webmaster Tools.
Pero Google dice que un sitemap no garantiza que todo lo que incluye se rastree e indexe. Tómalo como un respaldo. Los enlaces siguen siendo como se encuentran y se entienden las páginas.
Lo que lee primero el rastreador: título, descripción y H1
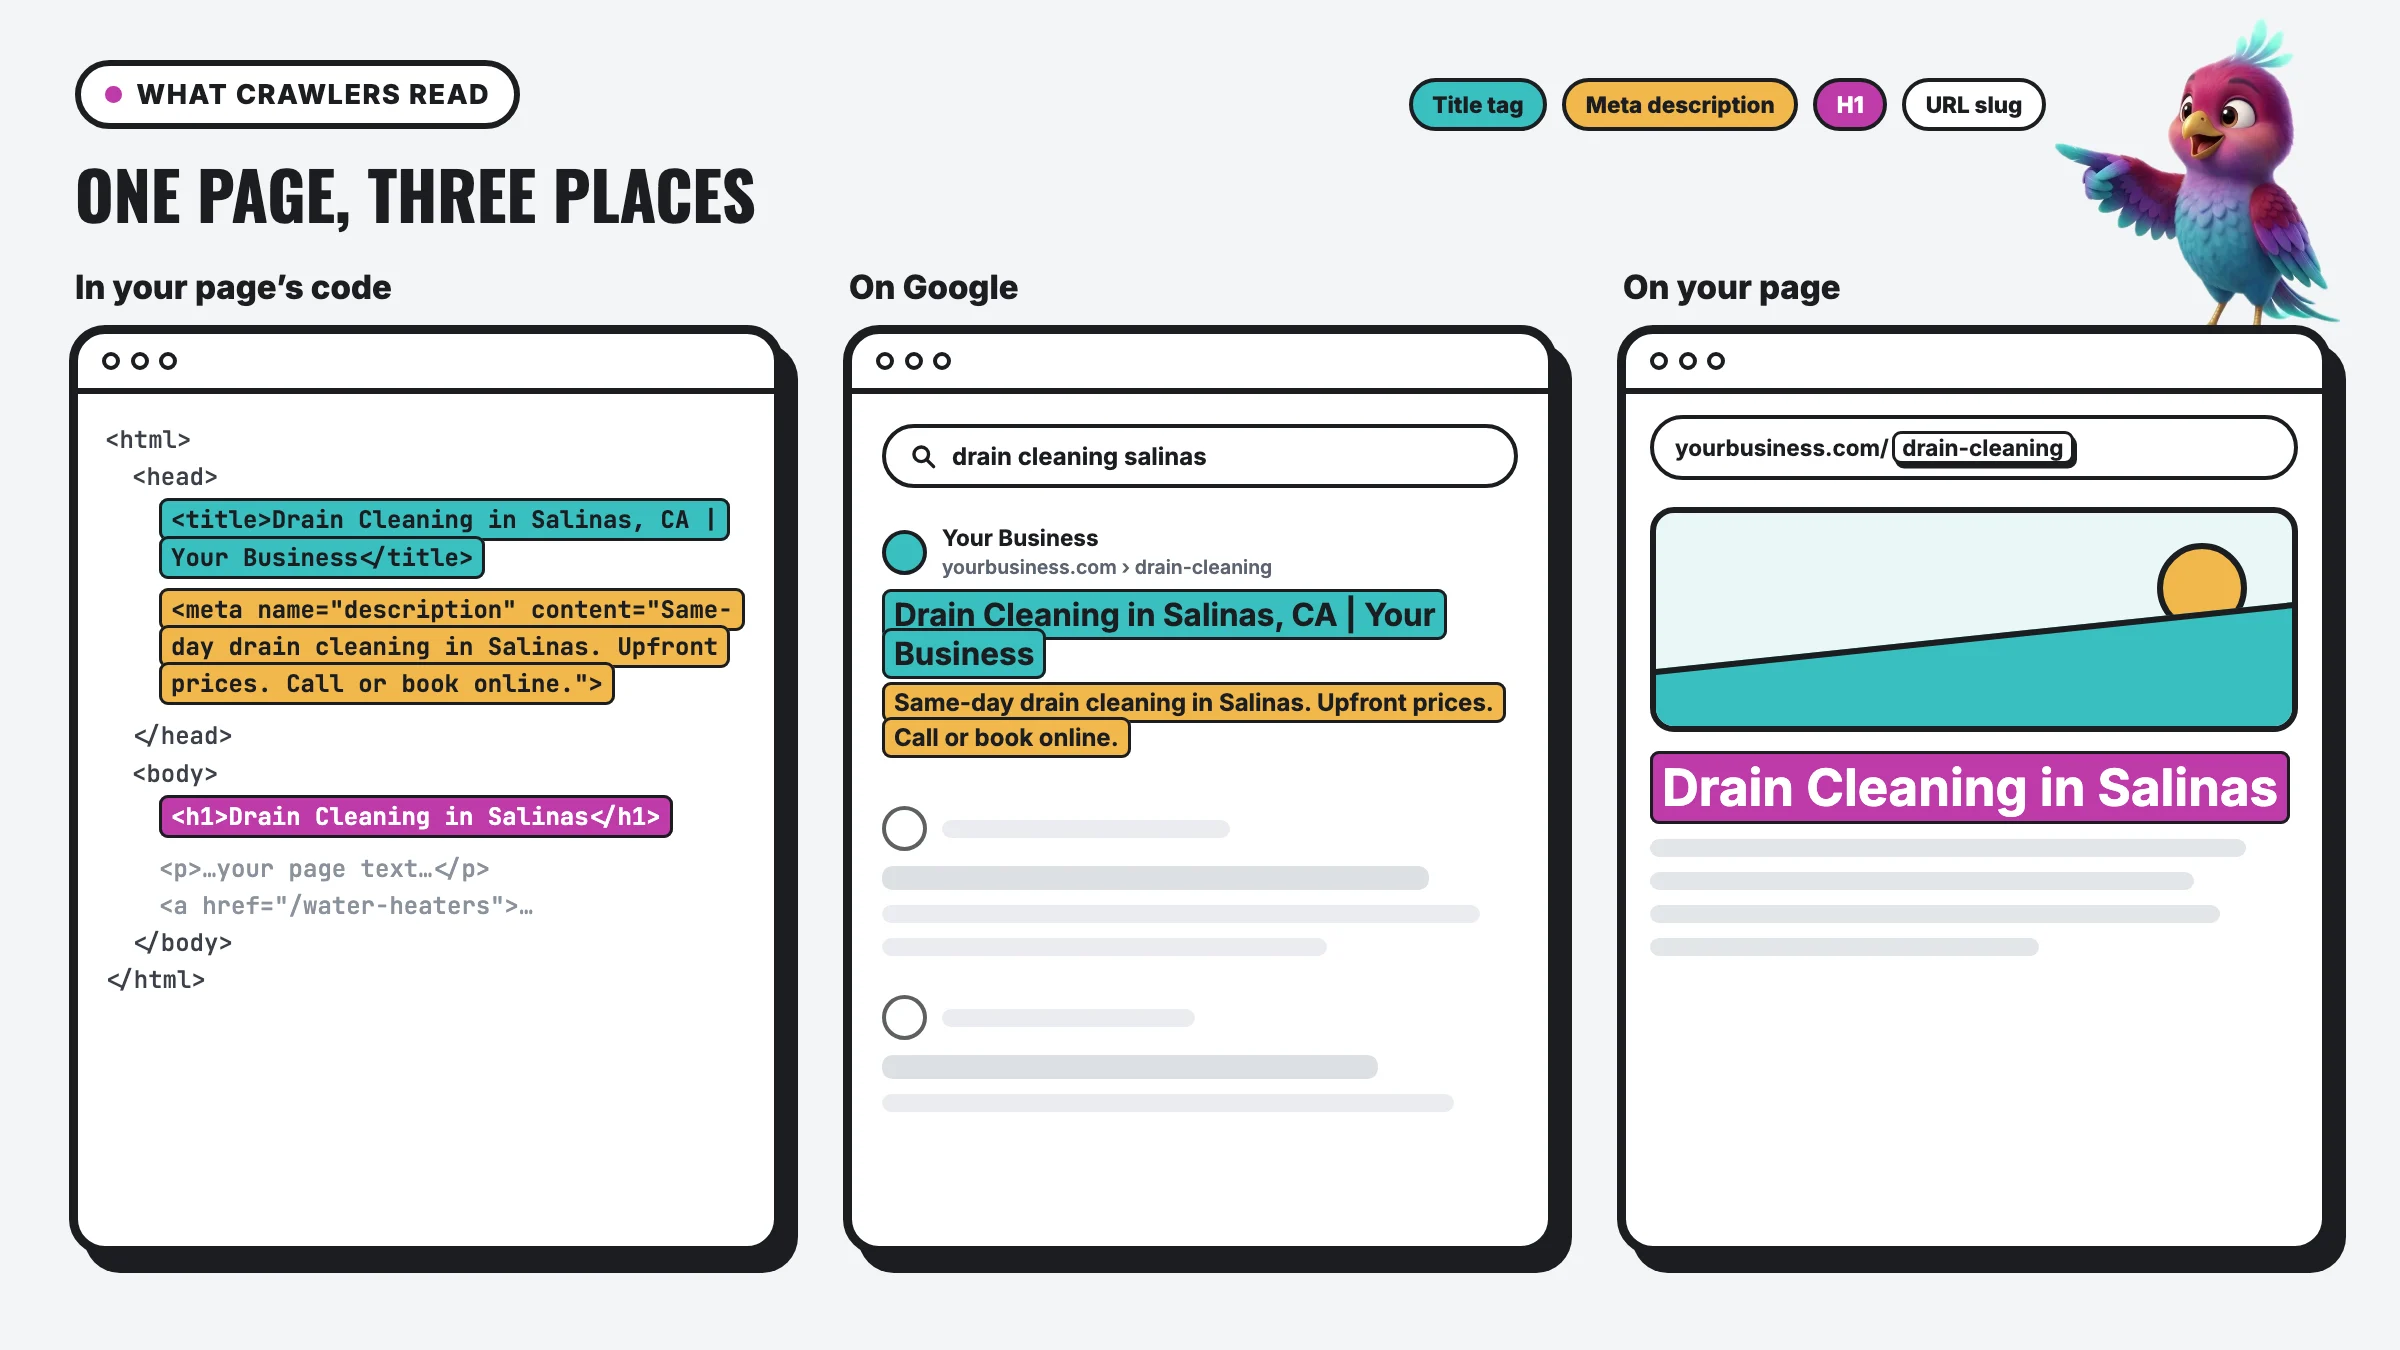 La etiqueta title Vive en la parte head del código. Tus clientes no la ven en la página, pero Google la usa para tu enlace azul. La meta descripción Un resumen de una o dos frases, también escondido en el código. Google puede mostrarlo debajo de tu enlace. El H1 El título principal de la página en el código. Google dice que los encabezados como el H1 son de lo que lee para nombrar tu página. Texto y enlaces Las palabras y los enlaces que leen los rastreadores. Los enlaces tienen que ser enlaces <a href> reales para que Google los siga. Lo que escribió el cliente “drain cleaning salinas.” La página con palabras claras que coinciden tiene la mejor oportunidad. Nombre y dirección El nombre de tu sitio y la dirección de la página, arriba del enlace. La etiqueta title, como enlace Google casi siempre arma el enlace azul con tu etiqueta title, pero puede reescribirlo con tu H1 u otro texto. La meta descripción, como texto Google arma el texto casi siempre con el contenido de tu página, y usa tu meta descripción cuando describe mejor la página. La dirección (slug) “drain-cleaning.” Palabras cortas y claras son mejores que números y códigos. El H1, en la página El título grande que sí ven tus clientes. Debe decir de qué trata la página en palabras sencillas. El resto de la página Los rastreadores la leen toda para decidir qué búsquedas responde.
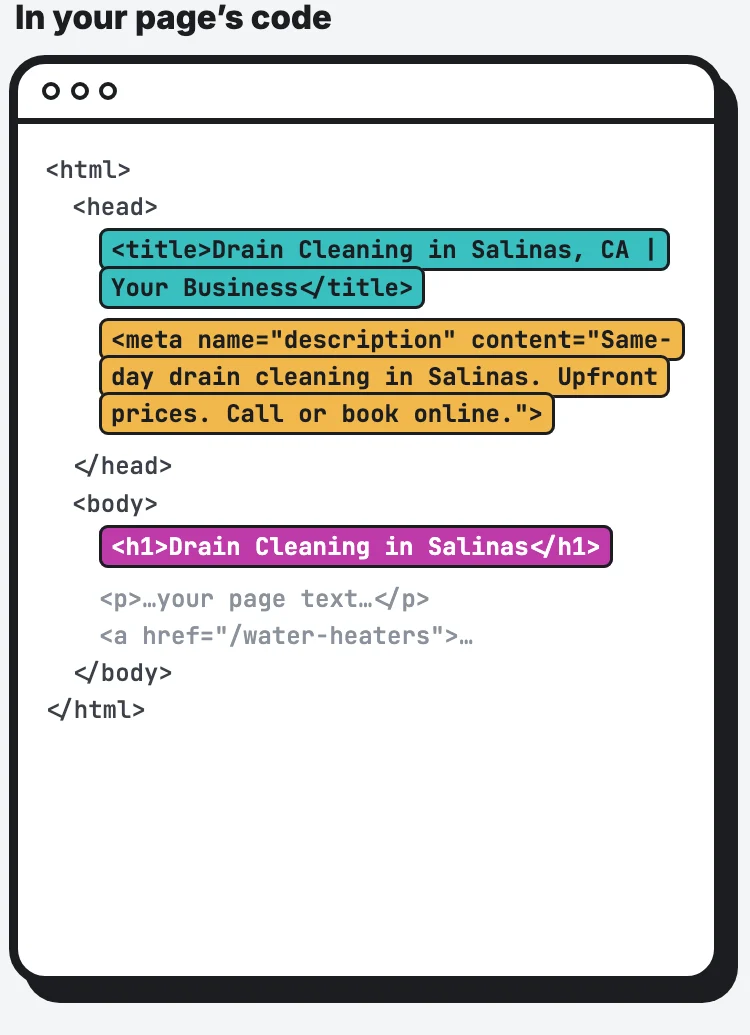
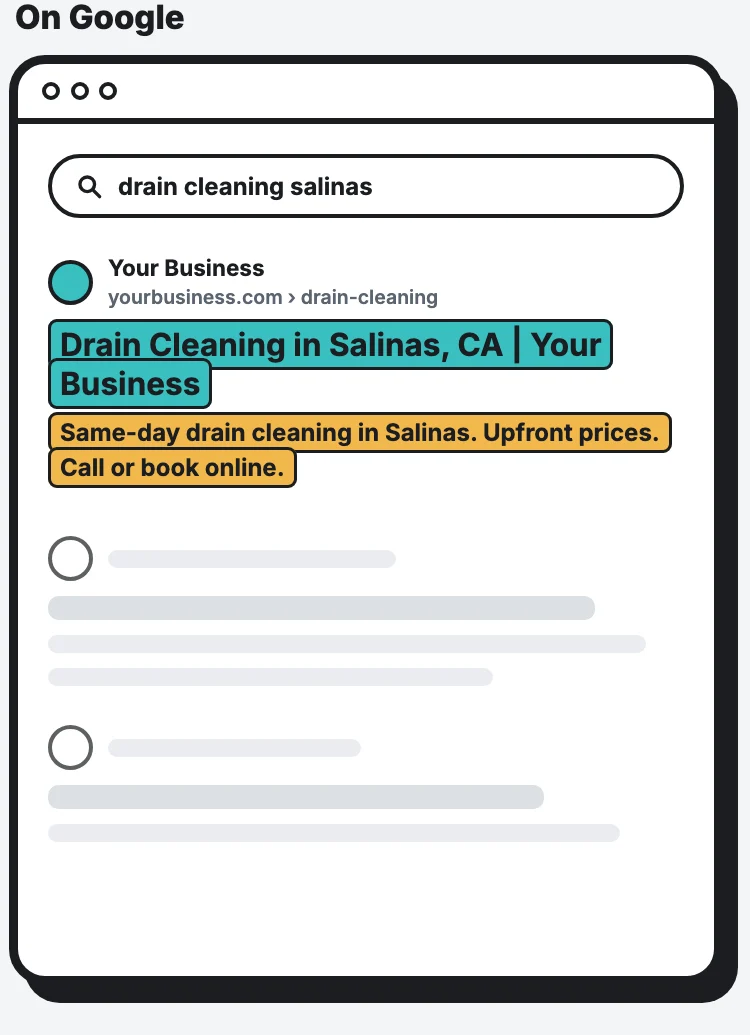
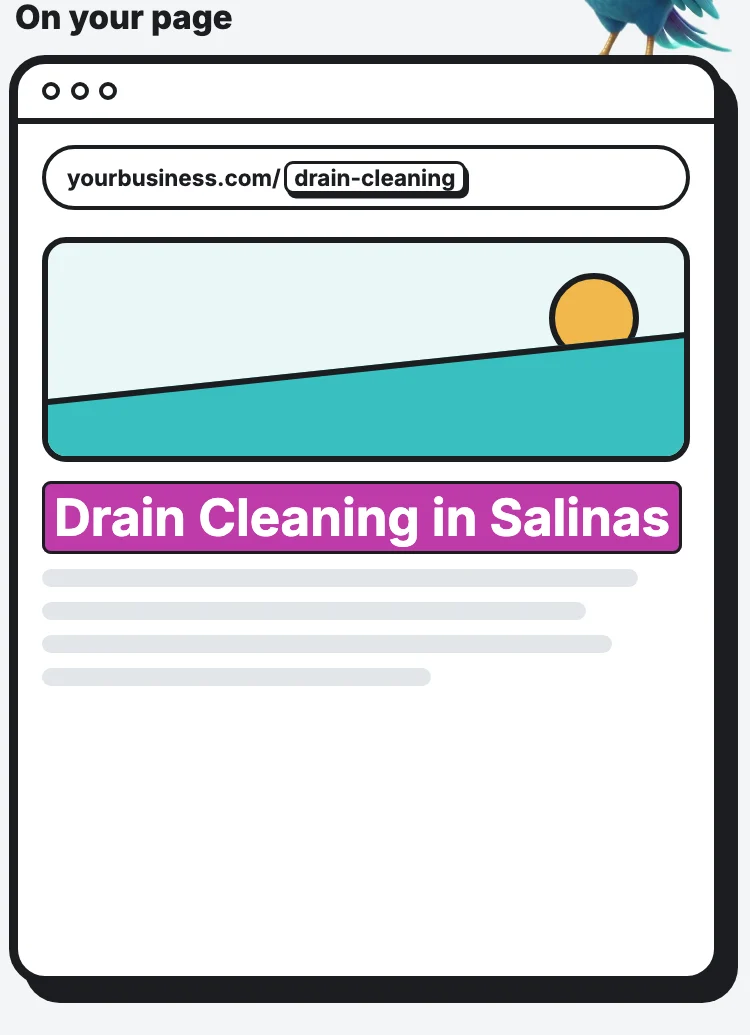
Verde azulado es la etiqueta title, amarillo la meta descripción, rosa el H1. Negocio de ejemplo. (El gráfico está en inglés; aquí te explico cada parte.)
Ilustración adaptada del diagrama “código, SERP, página” de Semrush, redibujada por Digital Vibes con un ejemplo local.
Una misma página vista de tres formas: en su código, en Google y en la página. Pasa el cursor por cualquier parte para una explicación rápida, o haz clic y la IA te la explica.
Cuando un rastreador llega a una página, lo lee todo. Tres líneas hacen el trabajo más visible, y el gráfico muestra cada una en tres lugares: tu código, los resultados de Google y tu página.
La etiqueta title vive en el código de tu página. Tus clientes no la ven en la página, pero Google casi siempre la usa para el enlace azul en los resultados. Google también dice que puede armar ese enlace con otras fuentes, como tu título principal. Dale a cada página su propio título claro: el servicio, la ciudad y el nombre de tu negocio.
La meta descripción es un resumen de una o dos frases, también escondido en el código. Google dice que usa principalmente el contenido de la página para el texto debajo de tu enlace, y usa la meta descripción cuando describe mejor la página. Google dijo en 2009 que no usa la meta descripción para posicionar, pero una clara te puede ganar el clic.
El H1 es el título grande que la gente ve en la página. Debe decir de qué trata en palabras sencillas. No tiene que ser igual al title palabra por palabra, pero deben coincidir en la idea.
Y la dirección o slug (“drain-cleaning”) debe ser corta y con palabras que se lean, no números.
robots.txt: el ajuste que puede esconder tu sitio
Cada sitio puede tener un archivo robots.txt que les dice a los rastreadores qué pueden visitar. Una sola línea, Disallow: /, les dice que no entren a nada. Es para sitios de prueba antes de lanzar. Si ese ajuste se copia al sitio en vivo, bloquea todo.
Dos cosas que los dueños entienden mal:
- robots.txt no quita una página de Google. Google dice que no es una forma de mantener una página fuera de Google. Para eso usa una etiqueta noindex o una contraseña.
- Bloquear un rastreador bloquea lo que ese rastreador alimenta. Eso importa para la búsqueda con IA.
Rastreadores de IA: a cuáles dejar entrar
Las empresas de IA también rastrean, y no todas hacen lo mismo. OpenAI tiene dos bots distintos: OAI-SearchBot es el que muestra sitios en las funciones de búsqueda de ChatGPT, y GPTBot junta contenido que se puede usar para entrenar sus modelos. Puedes permitir uno y bloquear el otro.
Google funciona igual. Su ajuste Google-Extended controla si tu contenido puede ayudar a entrenar a Gemini, y Google dice que no afecta que tu sitio aparezca en la Búsqueda de Google ni se usa para posicionar.
Mi consejo para un negocio local: no bloquees los rastreadores de búsqueda. Si quieres que te encuentren en ChatGPT, OAI-SearchBot necesita entrar. Los bots de entrenamiento son decisión tuya. Más sobre lo que lee la IA en de dónde saca la IA su información.
Cómo rastrear tu propio sitio gratis
No necesitas ser técnico para ver tu sitio como lo ve un rastreador:
- Google Search Console: pega cualquier dirección en URL Inspection para ver si Google la tiene y cuándo la rastreó por última vez. El reporte Pages muestra qué está indexado y por qué otras páginas no. Nuestra lección de Search Console lo explica paso a paso.
- Bing Webmaster Tools: tiene su propia URL Inspection y un Site Scan que revisa enlaces rotos y títulos que faltan. Mira nuestra lección de Bing Webmaster Tools.
- Screaming Frog SEO Spider: un rastreador de escritorio que rastrea 500 páginas gratis, suficiente para muchos sitios de negocios pequeños. Te lista cada página con su título, descripción, H1 y enlaces rotos.
Una revisión de rastreo de 10 minutos
- ¿Llegas a cada página importante desde el menú o desde otra página? Si no, agrega un enlace.
- ¿Cada página tiene su propio title y su propio H1? Dos páginas no deben compartirlos.
- ¿Enviaste tu sitemap en Search Console y en Bing Webmaster Tools?
- ¿Tu robots.txt (yourbusiness.com/robots.txt) bloquea algo que no debería?
- Inspecciona tu página más nueva en Search Console. ¿Está indexada?
Cada sitio web que construimos tiene Google Search Console desde el primer día, para ver qué ha encontrado Google. Si prefieres recibir los números sin entrar a ningún lado, el Reporte de tu Sitio Web te los manda cada mes en palabras sencillas.
Preguntas frecuentes
¿Qué es un rastreador web en palabras sencillas? Un programa que visita páginas web, las lee y sigue sus enlaces para encontrar más páginas. Los buscadores los usan para armar su índice.
¿Cómo hago que Google rastree mi sitio? Enlaza cada página importante desde otra página, envía tu sitemap en Search Console y usa URL Inspection para pedir que indexen las páginas nuevas o cambiadas.
¿Qué es una página huérfana? Una página sin enlaces que lleguen a ella desde el resto de tu sitio. A los rastreadores les cuesta encontrarla, así que puede nunca aparecer en búsquedas.
¿La meta descripción me ayuda a posicionar? Google dijo en 2009 que no la usa para posicionar. Aun así ayuda a que la gente decida hacer clic.
¿Debo bloquear a los rastreadores de IA? No a los que alimentan la búsqueda con IA, como OAI-SearchBot, si quieres aparecer ahí. Bloquear bots de entrenamiento como GPTBot o Google-Extended es decisión tuya y no afecta la Búsqueda de Google.
Resumen
Un rastreador web es el bot que encuentra y lee tus páginas, y casi siempre las encuentra siguiendo enlaces. Una página a la que nada enlaza puede quedarse invisible, un sitemap es solo un respaldo, y tu etiqueta title, tu meta descripción y tu H1 son lo primero que lee un rastreador para entender una página. Enlaza cada página que te importa, dale a cada una su propio título y encabezado claros, revisa que robots.txt no bloquee nada importante y revisa tu sitio en Search Console y Bing Webmaster Tools una vez al mes.